画像生成 AI がつづりを苦手とするのは、テキストではなく絵を描いているからです。文字がどんな形やピクセルの並びに見えるかを学習しており、単語を 1 文字ずつ打つことはないため、ちょっとしたミスで「BAKERY」が「BAKRERY」になってしまいます。また、多くのものはプロンプトを 1 文字ずつではなく単語の断片として読むため、正確なつづりはいっそう難しくなります。
新しい画像生成 AI は、初期のものよりずっと上手に短い文字を扱えますが、長い文章、小さな文字、珍しい名前、ラテン文字以外の文字では、今もミスが起こります。すでに文字が崩れた画像があるなら、やり直さなくても、AI 画像の文字化けを修正できることがよくあります。このガイドでは、ミスが起きる理由、よりよい文字を出すためのプロンプトの書き方、あとから直す方法を説明します。画像が Midjourney、ChatGPT、Gemini、Stable Diffusion、そのほかのどの画像生成 AI で作られたものでも、同じように使えます。
画像生成 AI が絵を作るしくみ
人気の画像生成 AI の多くは、拡散モデルという方式を使っています。モデルは、画面の砂嵐のようなランダムなノイズから始めて、たくさんのステップのそれぞれで、そのノイズを少しずつ取り除きます。プロンプトがすべてのステップを導くので、ノイズはゆっくりと、説明に合った絵に変わっていきます。画像全体が一緒に磨かれ、空も顔も文字も、同時に形になります。
すべての画像生成 AI がこの方式というわけではありません。画像を、小さな断片の連なりとして作るものもあります。ただ、一般にテキストから画像を生成するモデルには、1 つの重要な共通点があります。絵がどう見えるはずかを予測するということです。モデルがフォントを選び、「B」、「A」、「K」の順に打つ段階はありません。文字は、正しく見える形としてしか現れません。そのため、ほぼ合っているのにどこか違う、という仕上がりになることがあります。
画像生成 AI にとって文字がこれほど難しい理由
いくつかの原因が重なっています。どれも小さなミスを起こりやすくし、しかも文字は、小さなミスが目立ちやすい場所です。
文字は、厳しいルールのある小さなディテール
木は、枝がいくつあっても木に見えます。単語の正しいつづりは、ただ 1 つです。文字には、単語全体に当てはまるルールもあります。すべての文字が同じスタイルと高さで、間隔が均等で、同じ線の上に並んでいなければなりません。線が 1 本余分だったり、文字が抜けたり、文字が重複したりすると、画像のほかの部分が本物のように見えていても、その言語を読める人には一目でわかります。
モデルは、入力した文字そのものを見ていないことがある
画像生成 AI がプロンプトを使えるようになる前に、テキストエンコーダーと呼ばれる部品が、それを数字に変換します。多くのテキストエンコーダーは、まずプロンプトをトークンに分割します。一般的な単語は 1 つのトークンになることが多く、珍しい単語はいくつかの断片に分けられます。こうした断片を作る方法として広く使われているのが、バイト対符号化です。この方法は効率的ですが、モデルが受け取るのは、断片の中の文字ではなく、断片ごとの ID です。ある断片が、ある並びの文字として描かれるということは、例から学ぶしかありません。
Google Research の論文「Character-Aware Models Improve Visual Text Rendering」は、この点を直接調べました。研究者たちは、1 文字ずつを見るテキストエンコーダー(「character-aware」、文字を考慮するもの)と、単語の断片しか見ないエンコーダー(「character-blind」、文字を考慮しないもの)を比べました。「character-aware」のエンコーダーを持つ画像モデルは、画像内の文字をより正確に描き、特にまれな単語に強いという結果でした。また、この論文は、非常に大きな「character-blind」の言語モデルは、つづりをうまく学習できるものの、その能力は英語以外にはあまり広がらず、当時の画像生成 AI が一般に使っていたテキストエンコーダーよりはるかに大きなモデルでしか現れなかった、とも報告しています。
学習用の画像では、文字がきれいに写っていないことが多い
画像生成 AI は、説明文と組になった、非常に大規模な画像のコレクションから学習します。それらの画像の中の文字は、小さい、ぼやけている、切れている、斜めから見えている、一部が隠れているといったことが多く、非常に幅広いフォントやスタイルで現れます。画像と組になった説明文は、その中の文字にまったく触れていないこともあります。そのため、モデルは、文字が一般にどう見えるかについては多くの例を見ていますが、特定の単語を正確にどうつづるべきかについては、はっきりした例が少なくなります。
小さな文字は、ピクセルがごくわずか
見出しは数百ピクセルにわたることがありますが、小さな注意書きの単語は、1 文字あたり数ピクセルしか使えないことがあります。また、多くの画像生成 AI は、画像を圧縮したものの上で処理を行い、最後に原寸の画像を作り直すため、小さなディテールの余地はさらに少なくなります。小文字の「e」の横線のような細い線は、失われやすくなります。
新しいモデルほど文字がうまく書ける理由
画像生成 AI は、短い見出しやラベルが、ずっと上手になりました。一般に、新しいシステムは、プロンプトを理解するためにより強力な言語モデルを使い、開発者も学習の際に文字へより注意を払っています。上で紹介した研究も同じ方向を示しています。文字についてより良い情報を受け取るモデルは、文字をより正確に描きます。
改善は本物ですが、均一ではありません。3 語のタイトルを正しく書ける画像生成 AI でも、段落、メニュー、学習時にあまり見なかった言語のラベルでは、今もつまずくことがあります。
画像生成 AI が今もつまずきやすいところ
- 長い文章:段落、メニュー、リスト。単語が増えるたびに、ミスが起こる機会も増えます
- 小さな文字:細かい注意書き、ラベル、場面の奥のほうにある文字
- 珍しい単語:名前、造語、新しい用語、電話番号やコードのような長い数字
- ラテン文字以外の文字:アラビア語、中国語、ヒンディー語、日本語、韓国語、タイ語などの文字体系や、アクセント付きの文字
- 多くの文字ブロック:複数の離れた文字が入ったポスターやインフォグラフィック
- 曲面や斜めの面:瓶、旗、横から見た看板に入った文字
- 一貫性:一連の画像の中で、同じ文言を同じに保つこと
これらは、決まったルールではなく、よくある傾向であり、画像生成 AI やバージョンによって異なります。
画像を生成するときに、よりよい文字を出す方法
- 正確な文字をカギ括弧で囲む。たとえば、ナイトマーケットについてのポスターではなく、「NIGHT MARKET」というタイトルのポスターを頼みます。
- 文字を短くする。文章全体より、大きなサイズの数語のほうが、正しく出しやすくなります。長い文章は、代わりにキャプションやウェブページに入れます。
- 文字を置く場所を伝える。「上部いっぱいの大きなタイトル」「瓶の小さなラベル」のように、配置とサイズを説明します。
- シンプルな文字を頼む。複雑な背景の上の装飾的な筆記体より、無地の部分に太くてすっきりした大文字のほうが、モデルには描きやすくなります。
- 複数のバージョンを作る。いくつか生成して、つづりがいちばん良いものを選び、残った部分だけを直します。
- 大切なときは、正確な文字をあとから加える。メニュー、価格表、細かい注意書きのあるものは、空白を残して画像を生成し、デザインツールで文字を組みます。そうすれば、文言は描かれるのではなく、打ち込まれたものになります。
あとから文字を直す方法
絵は合っているのに文字が間違っているときは、主に 4 つの選択肢があります。手間の少ない順に紹介します。
| 方法 | 手間 | ほかに変わりうるもの | 向いているとき |
|---|---|---|---|
| 画像を生成し直す | 低 | すべて。新しい絵になるため | 画像全体が違う、またはこのバージョンを失ってもかまわない |
| 画像生成 AI の中で範囲を選んで編集する | 低 | 近くの範囲も描き直されることがある | 同じツールで手早く直したい |
| AI による文字の置き換えツール | 低〜中 | 文字の範囲が描き直されるため、結果を確認する | 絵は合っていて、文字だけが間違っている |
| 画像エディターで手作業で直す | 高 | 自分が変えたところだけ | 印刷物やクライアントの仕事など、完全にコントロールしたい |
画像を生成し直す
生成し直すのは手間がかかりませんが、結果はランダムです。新しく試すと、その単語は直っても、顔、手、レイアウトなど、ほかのものが崩れることがあります。この画像にまだあまり時間をかけていないときに使いましょう。
画像生成 AI の中で範囲を選んで編集する
範囲を指定して、変更内容を説明できる画像生成 AI もあります。たとえば ChatGPT では、選択ツールで文字をハイライトして、何と書くべきかを入力できます。OpenAI のヘルプセンターは、ハイライトが必ずしも正確ではないため、文字の近くの細部も変わることがあると説明しています。詳しくは、ChatGPT で画像の文字を編集できるかをご覧ください。
AI による文字の置き換えツールを使う
文字の置き換えツールは、画像の中の文字を検出してくれるので、入力するのは正しいつづりだけです。たとえば EditText.ai では、1 行ずつ画像の文字を編集でき、各行は元の文字と背景の見た目に合わせて描き直されます。1 文字や 1 語だけが間違っているなら、画像の誤字・脱字を修正する方法をご覧ください。イベントのデザインの見出しや装飾的な文字については、ポスターやチラシの文字を変更する方法をご覧ください。
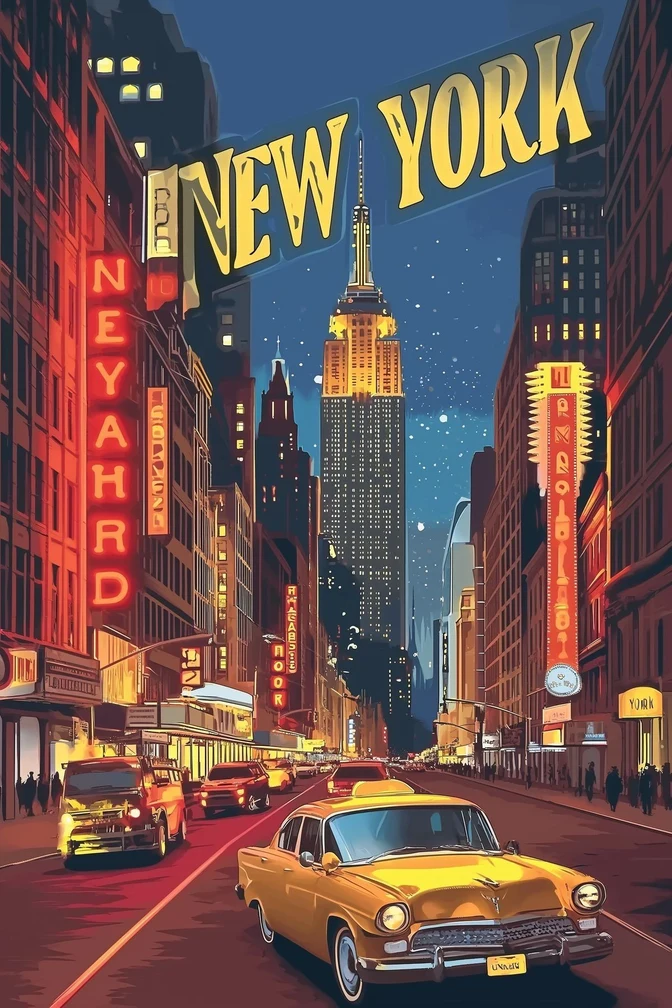
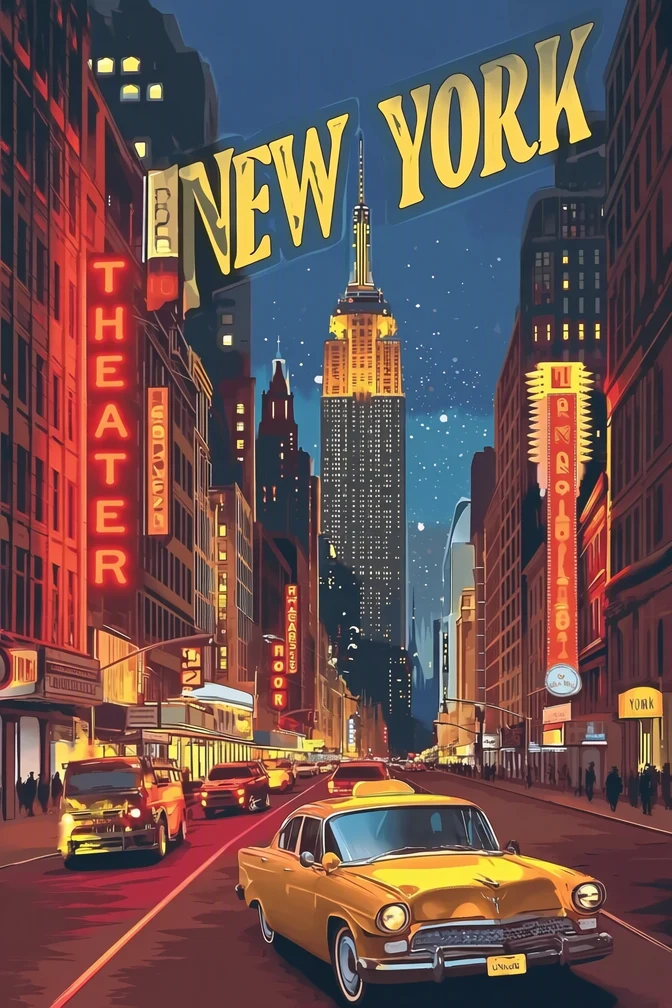
編集前と編集後:AI 画像の文字化けしたネオンサインを、EditText.ai で THEATER と入力して修正。
特に個性的な文字や細部の多い背景では、結果にばらつきがあります。描き直しも画像モデルが行うため、新しい単語はすべて、原寸で 1 文字ずつ読んでください。また、文字の検出は、崩れた文字を読み違えることもあるため、検出された各行が、変えるつもりだった行であることを確かめてください。
手作業で直す
Photoshop、Photopea などのエディターでは、崩れた文字を消し、背景を作り直して、フォントで新しい文字を組みます。最も細かくコントロールでき、印刷物やクライアントの仕事に向いていますが、スキルと時間が必要です。AI が描いた文字は、実在のフォントではないことが多いため、フォント探しのツールでは、一致するものが見つからないかもしれません。近い代わりを見つける方法は、画像からフォントを調べる方法をお読みください。
選ぶときは、簡単なルールが役に立ちます。画像全体が違うなら、生成し直す。文字だけが違うなら、文字を直す。
そのほかの選択肢
画像の文字を消すことで文字を完全になくし、きれいになった背景の上に、デザインツールで本物の文字を組むこともできます。メニューや価格表に向いたやり方です。文言が正しくなったら、画像の文字を翻訳して、ほかの言語のバージョンを作れます。
自分が所有している、または変更する許可を得ている画像だけを編集し、透かしやクレジット表記は消さず、プラットフォームが求める AI 画像の表示は残してください。
絵はそのままに、文字だけを直す
絵は合っているのにつづりが間違っているなら、やり直す必要はありません。EditText.ai に画像をアップロードしてAI 画像の文字化けを修正し、行ごとに正しい文字を入力して、ダウンロードする前に結果を確認します。
よくある質問
AI が画像の中の文字を間違えるのはなぜですか?
画像生成 AI は、文字を、文字として打つのではなく、形として描きます。また、多くはプロンプトを 1 文字ずつではなく単語の断片として読みます。文字は、厳しいルールのある小さなディテールでもあるため、線が 1 本違うだけで目立ちます。学習用の画像では、文字が小さい、ぼやけている、斜めになっていることが多く、モデルが学べる、はっきりした例が少なくなります。
AI が本物の単語ではなく、意味のない文字を書くのはなぜですか?
モデルは、単語のつづりに自信がないときも、文字のように見える形を描きます。学習用の画像では、文字がそう見えているからです。結果は、文字のような記号、混ざった文字体系、造語になることがあります。長い文章、小さな文字、珍しい単語で最も起こりやすく、カギ括弧で囲んだ短いフレーズでは、起こりにくくなります。
文字がいちばん上手な画像生成 AI はどれですか?
ずっと変わらない答えはありません。モデルは頻繁に変わり、新しいバージョンごとに挙動が違うことがあるからです。一般に、最近の画像生成 AI は、大きな短い文字を、以前のものより上手に扱えます。いちばん役に立つ試し方は、自分のプロンプトです。使えるツールで同じ短いフレーズを生成し、1 つ選ぶ前に、つづりを 1 文字ずつ確認します。
生成し直さずに、AI 画像のつづりの間違いを直せますか?
はい。同じ画像生成 AI の中で範囲を選んで直し方を説明する、Photoshop や Photopea のようなエディターで手作業で文字を打ち直す、単語を検出してくれる文字の置き換えツールで正しいつづりを入力する、といった方法があります。どの方法でも、結果を元の画像と見比べて、文字の近くの変化を見つけてください。
フォント探しのツールで、AI 画像の文字を特定できないのはなぜですか?
画像生成 AI は、たいていインストールされたフォントファイルではなく、学習したパターンから文字を描きます。文字は、複数の書体の特徴が混ざっていたり、1 文字ごとに形が変わったりすることがあります。フォント判別ツールが似たフォントを提案してくれることはあり、文字を打ち直すつもりなら役に立ちますが、完全に一致するものは、存在しないことがよくあります。