AI-afbeeldingsgeneratoren hebben moeite met spelling omdat ze afbeeldingen tekenen en geen tekst. Ze leren hoe letters eruitzien als vormen en patronen van pixels en typen nooit een woord letter voor letter, dus een kleine misser kan van “BAKERY” “BAKRERY” maken. Veel generatoren lezen je prompt bovendien in woordstukken in plaats van in losse letters, waardoor precieze spelling nog lastiger wordt.
Nieuwere generatoren gaan veel beter om met korte tekst dan de eerste versies, maar lange stukken tekst, kleine letters, ongewone namen en niet-Latijnse schriften leiden nog steeds tot fouten. Heb je al een afbeelding met kapotte woorden, dan kun je vaak tekst in AI-gegenereerde afbeeldingen corrigeren zonder helemaal opnieuw te beginnen. In deze gids lees je waarom de fouten ontstaan, hoe je een prompt schrijft voor betere tekst en hoe je de tekst achteraf herstelt, of de afbeelding nu uit Midjourney, ChatGPT, Gemini, Stable Diffusion of een andere generator komt.
Hoe AI-afbeeldingsgeneratoren een afbeelding maken
Veel populaire afbeeldingsgeneratoren gebruiken een methode die een diffusiemodel heet. Het model begint met willekeurige ruis, vergelijkbaar met sneeuw op een tv-scherm, en haalt in elk van veel stappen een beetje van die ruis weg. Je prompt stuurt elke stap, zodat de ruis langzaam verandert in een afbeelding die bij je beschrijving past. De hele afbeelding wordt tegelijk verfijnd: de lucht, de gezichten en de letters krijgen allemaal tegelijk vorm.
Niet elke generator werkt zo. Sommige bouwen de afbeelding op als een reeks kleine stukjes. Maar in het algemeen hebben text-to-image-modellen één belangrijke eigenschap gemeen: ze voorspellen hoe de afbeelding eruit moet zien. Er is geen stap waarin het model een lettertype kiest en “B”, dan “A” en dan “K” typt. Letters verschijnen alleen als vormen die er goed uitzien, en daarom kunnen ze er bijna goed maar niet helemaal goed uitkomen.
Waarom tekst zo moeilijk is voor afbeeldingsgeneratoren
Meerdere oorzaken werken samen. Elke oorzaak maakt een kleine fout waarschijnlijker, en tekst is een plek waar kleine fouten gemakkelijk opvallen.
Letters zijn kleine details met strikte regels
Een boom kan een willekeurig aantal takken hebben en toch op een boom lijken. Een woord heeft precies één juiste spelling. Tekst heeft bovendien regels die voor het hele woord gelden: elke letter moet dezelfde stijl en hoogte hebben, de tussenruimte moet gelijkmatig zijn en de letters moeten op dezelfde lijn staan. Eén streepje te veel, een ontbrekende letter of een dubbele letter valt elke lezer van de taal meteen op, ook als de rest van de afbeelding echt oogt.
Het model ziet de letters die je typte misschien nooit
Voordat een generator je prompt kan gebruiken, zet een onderdeel dat een tekstencoder heet de prompt om in getallen. Veel tekstencoders splitsen de prompt eerst in tokens. Gewone woorden worden vaak één token, terwijl zeldzamere woorden in meerdere stukken worden opgedeeld. Een veelgebruikte methode om deze stukken te maken is byte-pair encoding. De aanpak is efficiënt, maar het model krijgt een ID voor elk stuk en niet de letters erin. Het moet uit voorbeelden leren dat een bepaald stuk wordt getekend als een bepaalde reeks letters.
In een onderzoeksartikel van Google Research, Character-Aware Models Improve Visual Text Rendering, is dit rechtstreeks onderzocht. De onderzoekers vergeleken tekstencoders die losse tekens zien (“character-aware”) met encoders die alleen woordstukken zien (“character-blind”). Afbeeldingsmodellen met character-aware encoders gaven visuele tekst nauwkeuriger weer en waren vooral sterk bij zeldzame woorden. Het artikel vond ook dat zeer grote character-blind taalmodellen goed kunnen leren spellen, maar dat die vaardigheid niet goed doorwerkte buiten het Engels en alleen optrad in modellen die veel groter zijn dan de tekstencoders die afbeeldingsgeneratoren destijds meestal gebruikten.
Trainingsafbeeldingen tonen tekst vaak slecht
Generatoren leren van zeer grote verzamelingen afbeeldingen met bijbehorende beschrijvingen. In die afbeeldingen is tekst vaak klein, wazig, afgesneden, schuin gezien of deels verborgen, en komt die voor in een enorm scala aan lettertypen en stijlen. De beschrijving bij een afbeelding noemt de tekst erin soms helemaal niet. Het model ziet dus veel voorbeelden van hoe tekst er in het algemeen uitziet, maar minder duidelijke voorbeelden van hoe een bepaald woord precies gespeld moet worden.
Kleine tekst heeft heel weinig pixels
Een kop kan honderden pixels breed zijn, terwijl een woord in kleine lettertjes misschien maar een paar pixels per letter krijgt. Veel generatoren werken bovendien met een gecomprimeerde versie van de afbeelding en bouwen de afbeelding op volledige grootte pas aan het eind weer op, waardoor er nog minder ruimte is voor kleine details. Fijne lijnen, zoals de streep in een kleine “e”, gaan gemakkelijk verloren.
Waarom nieuwere modellen betere tekst schrijven
Afbeeldingsgeneratoren zijn veel beter geworden in korte koppen en labels. In het algemeen gebruiken nieuwere systemen sterkere taalmodellen om de prompt te begrijpen, en hebben ontwikkelaars tijdens de training meer aandacht aan tekst besteed. Het onderzoek hierboven wijst dezelfde kant op: modellen die betere informatie over letters krijgen, tekenen tekst nauwkeuriger.
De verbetering is echt, maar ongelijk. Een generator die een titel van drie woorden goed schrijft, kan nog steeds moeite hebben met een alinea, een menukaart of een label in een taal die hij tijdens de training minder vaak zag.
Waar AI-afbeeldingsgeneratoren nog steeds moeite mee hebben
- Lange tekst. Alinea's, menukaarten en lijsten, waar elk extra woord weer een kans op een fout is
- Kleine tekst. Kleine lettertjes, labels en tekst ver weg in een scène
- Ongewone woorden. Namen, verzonnen woorden, nieuwe termen en lange getallen zoals telefoonnummers of codes
- Niet-Latijnse schriften. Arabisch, Chinees, Hindi, Japans, Koreaans, Thai en andere schriftsystemen, evenals letters met accenten
- Veel tekstblokken. Posters en infographics met meerdere afzonderlijke stukken tekst
- Gebogen of schuine vlakken. Tekst op een fles, een vlag of een bord dat van opzij te zien is
- Consistentie. Dezelfde tekst identiek houden in een reeks afbeeldingen
Dit zijn veelvoorkomende patronen en geen vaste regels, en ze verschillen van generator tot generator en van versie tot versie.
Zo krijg je betere tekst als je een afbeelding genereert
- Zet de exacte woorden tussen aanhalingstekens. Vraag bijvoorbeeld om een poster met de titel “NIGHT MARKET” in plaats van een poster over een nachtmarkt.
- Houd de tekst kort. Een paar woorden in een groot formaat zijn makkelijker goed te krijgen dan een volledige zin. Zet langere tekst liever in een bijschrift of op een webpagina.
- Zeg waar de tekst moet komen. Beschrijf de plaatsing en het formaat, zoals “grote titel over de bovenkant” of “klein etiket op de pot”.
- Vraag om eenvoudige letters. Vette, strakke hoofdletters op een effen vlak zijn voor een model makkelijker te tekenen dan decoratieve schrijfletters over een drukke achtergrond.
- Maak meerdere versies. Genereer een paar opties, kies die met de beste spelling en herstel alleen wat er nog over is.
- Voeg exacte tekst later toe als het ertoe doet. Genereer voor een menukaart, een prijslijst of alles met kleine lettertjes de afbeelding met lege ruimte en zet de tekst in een ontwerptool. Zo is de tekst getypt en niet getekend.
Zo herstel je de tekst achteraf
Klopt de afbeelding maar zijn de woorden fout, dan heb je vier hoofdopties. Hier staan ze van de minste naar de meeste moeite.
| Methode | Moeite | Wat er nog meer kan veranderen | Het beste als |
|---|---|---|---|
| De afbeelding opnieuw genereren | Laag | Alles, want je krijgt een nieuwe afbeelding | De hele afbeelding is fout, of je vindt het niet erg deze versie kwijt te raken |
| Selecteren en bewerken in de generator | Laag | Gebieden in de buurt kunnen ook opnieuw worden getekend | Je een snelle oplossing in dezelfde tool wilt |
| Tool voor AI-tekstvervanging | Laag tot gemiddeld | Het tekstgebied wordt opnieuw getekend, dus controleer het resultaat | De afbeelding klopt en alleen de woorden zijn fout |
| Met de hand herstellen in een beeldbewerker | Hoog | Alleen wat je zelf verandert | Je volledige controle nodig hebt, bijvoorbeeld voor drukwerk of klantwerk |
De afbeelding opnieuw genereren
Opnieuw genereren kost weinig moeite, maar het resultaat is willekeurig. Een nieuwe poging kan het woord goed maken en iets anders kapotmaken, zoals een gezicht, een hand of de lay-out. Gebruik het als je nog niet veel tijd aan precies deze afbeelding hebt besteed.
Selecteren en bewerken in de generator
Met sommige generatoren kun je een gebied markeren en een wijziging beschrijven. In ChatGPT kun je bijvoorbeeld de tekst markeren met een selectiegereedschap en typen wat er moet staan. Het helpcentrum van OpenAI vermeldt dat markeringen niet altijd nauwkeurig zijn, dus ook details bij de tekst kunnen veranderen. Voor meer uitleg lees je kan ChatGPT tekst in een afbeelding bewerken.
Gebruik een tool voor AI-tekstvervanging
Een tool voor tekstvervanging herkent de tekst in de afbeelding voor je, zodat je alleen de juiste spelling hoeft te typen. Met EditText.ai kun je bijvoorbeeld regel voor regel tekst in een afbeelding bewerken, en elke regel wordt opnieuw getekend in de stijl van de oorspronkelijke letters en achtergrond. Voor één verkeerde letter of één verkeerd woord lees je hoe je een typfout in een afbeelding verbetert. Voor koppen en sierletters op evenementontwerpen lees je hoe je tekst op een poster wijzigt.
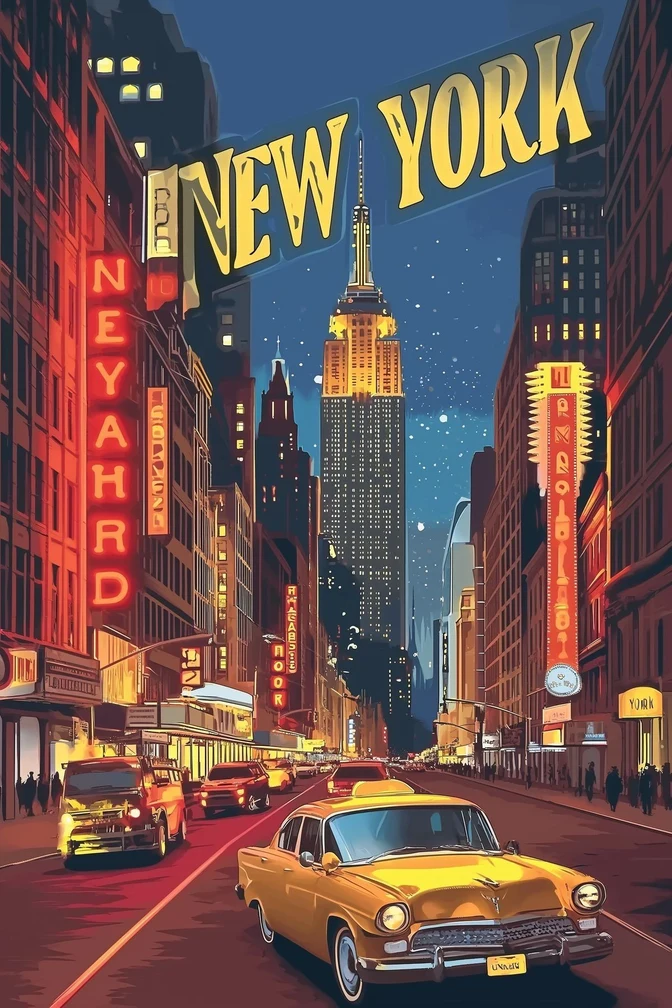
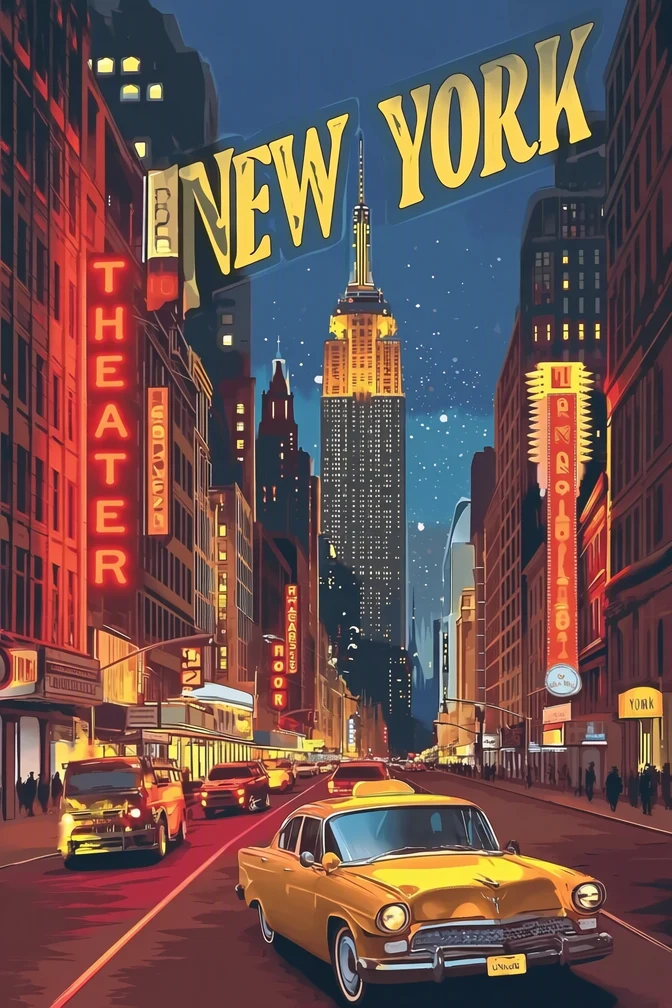
Voor en na: een onleesbaar neonbord in een AI-afbeelding, gecorrigeerd door THEATER te typen in EditText.ai.
De resultaten kunnen variëren, vooral bij ongebruikelijke letters of gedetailleerde achtergronden. Omdat het opnieuw tekenen ook door een afbeeldingsmodel gebeurt, lees je elk nieuw woord letter voor letter op volledige grootte. Elke tekstherkenning kan onleesbare letters ook verkeerd lezen, dus controleer of elke herkende regel de regel is die je wilde wijzigen.
Met de hand herstellen
In Photoshop, Photopea of een vergelijkbare editor verwijder je de kapotte letters, bouw je de achtergrond opnieuw op en zet je nieuwe tekst in een lettertype. Dat geeft je de meeste controle en past bij drukwerk of klantwerk, maar het kost vaardigheid en tijd. AI-letters zijn vaak geen echt lettertype, dus een lettertypezoeker vindt mogelijk geen match. Lees hoe je een lettertype in een afbeelding herkent voor manieren om een goede vervanger te vinden.
Een eenvoudige regel helpt je kiezen: is de hele afbeelding fout, genereer die dan opnieuw. Zijn alleen de woorden fout, herstel dan de woorden.
Andere opties
Je kunt ook tekst uit een afbeelding verwijderen en in een ontwerptool echte tekst op de schone achtergrond zetten, een goede aanpak voor menukaarten en prijslijsten. Als de tekst eenmaal klopt, kun je tekst in een afbeelding vertalen om versies voor andere talen te maken.
Bewerk alleen afbeeldingen die van jou zijn of die je mag wijzigen, verwijder geen watermerken of bronvermeldingen en laat AI-labels staan die een platform vereist.
Herstel de woorden en behoud de afbeelding
Klopt de afbeelding maar is de spelling fout, dan hoef je niet helemaal opnieuw te beginnen. Upload de afbeelding om met EditText.ai tekst in AI-afbeeldingen te corrigeren, typ voor elke regel de juiste woorden en controleer het resultaat voordat je het downloadt.
Veelgestelde vragen
Waarom maakt AI er een rommeltje van met tekst in afbeeldingen?
AI-afbeeldingsgeneratoren tekenen tekst als vormen in plaats van die als letters te typen, en veel generatoren lezen prompts in woordstukken in plaats van in losse tekens. Tekst is bovendien een klein detail met strikte regels, dus één verkeerde streek valt op. Trainingsafbeeldingen tonen tekst vaak klein, wazig of schuin, waardoor modellen minder duidelijke voorbeelden hebben om van te leren.
Waarom schrijft AI onzin in plaats van echte woorden?
Als een model niet zeker weet hoe een woord gespeld wordt, tekent het toch vormen die op letters lijken, omdat tekst er in zijn trainingsafbeeldingen zo uitziet. Het resultaat kunnen lettervormige tekens, gemengde alfabetten of verzonnen woorden zijn. Het gebeurt het vaakst bij lange tekst, kleine letters en ongewone woorden, en minder vaak bij een korte zin tussen aanhalingstekens.
Welke AI-afbeeldingsgenerator is het best in tekst?
Daar is geen blijvend antwoord op, omdat modellen vaak veranderen en elke nieuwe versie zich anders kan gedragen. In het algemeen gaan recente generatoren beter om met korte, grote tekst dan oudere. De nuttigste test is je eigen prompt: genereer dezelfde korte zin in de tools waar je toegang toe hebt en controleer de spelling letter voor letter voordat je er een kiest.
Kan ik verkeerd gespelde tekst in een AI-afbeelding herstellen zonder opnieuw te genereren?
Ja. Je kunt het gebied selecteren en de oplossing beschrijven in dezelfde generator, de tekst met de hand opnieuw typen in een editor zoals Photoshop of Photopea, of een tool voor tekstvervanging gebruiken die de woorden herkent zodat je de juiste spelling kunt typen. Welke methode je ook gebruikt, vergelijk het resultaat met het origineel om wijzigingen bij de tekst op te merken.
Waarom kan een lettertypezoeker de letters in mijn AI-afbeelding niet herkennen?
AI-generatoren tekenen letters meestal op basis van patronen die ze hebben geleerd en niet uit een geïnstalleerd lettertypebestand. De letters kunnen kenmerken van meerdere lettertypen mengen of van de ene letter op de andere van vorm veranderen. Een lettertypeherkenner kan nog steeds vergelijkbare lettertypen voorstellen, wat helpt als je de tekst opnieuw wilt typen, maar een exacte match bestaat vaak niet.