Penjana imej AI sukar mengeja kerana ia melukis gambar, bukan menaip teks. Ia mempelajari rupa huruf sebagai bentuk dan corak piksel, dan ia tidak pernah menaip sesuatu perkataan satu huruf demi satu huruf, jadi satu kesilapan kecil boleh menukar “BAKERY” menjadi “BAKRERY”. Banyak daripadanya juga membaca prompt anda dalam kepingan perkataan dan bukan huruf individu, yang menjadikan ejaan yang tepat lebih sukar lagi.
Penjana yang lebih baharu mengendalikan teks pendek jauh lebih baik daripada yang terdahulu, tetapi teks yang panjang, huruf kecil, nama yang luar biasa dan sistem tulisan bukan Latin masih menyebabkan kesilapan. Jika anda sudah mempunyai imej dengan perkataan yang rosak, anda selalunya boleh membetulkan teks dalam gambar janaan AI tanpa bermula semula. Panduan ini menerangkan mengapa kesilapan itu berlaku, cara memberi prompt untuk mendapatkan teks yang lebih baik, dan cara membaikinya kemudian, sama ada imej itu datang daripada Midjourney, ChatGPT, Gemini, Stable Diffusion atau penjana lain.
Cara penjana imej AI menghasilkan gambar
Banyak penjana imej yang popular menggunakan kaedah yang dipanggil model resapan (diffusion model). Model itu bermula dengan hingar rawak, serupa dengan statik pada skrin, dan membuang sedikit hingar itu dalam setiap satu daripada banyak langkah. Prompt anda memandu setiap langkah, jadi hingar itu perlahan-lahan bertukar menjadi gambar yang sepadan dengan penerangan anda. Seluruh imej diperhalusi bersama-sama: langit, wajah dan huruf semuanya terbentuk pada masa yang sama.
Tidak semua penjana berfungsi dengan cara ini. Ada yang membina imej sebagai urutan kepingan kecil. Tetapi secara amnya, model teks-ke-imej berkongsi satu ciri penting: ia meramalkan rupa gambar yang sepatutnya. Tiada langkah ketika model memilih fon lalu menaip “B”, kemudian “A”, kemudian “K”. Huruf muncul hanya sebagai bentuk yang kelihatan betul; itulah sebabnya ia boleh terhasil hampir betul tetapi tidak tepat sepenuhnya.
Mengapa teks begitu sukar bagi penjana imej
Beberapa punca bekerja bersama-sama. Setiap satunya menjadikan kesilapan kecil lebih berkemungkinan, dan teks ialah tempat kesilapan kecil mudah dilihat.
Huruf ialah butiran kecil dengan peraturan yang ketat
Pokok boleh mempunyai sebarang bilangan dahan dan masih kelihatan seperti pokok. Sesuatu perkataan mempunyai tepat satu ejaan yang betul. Teks juga mempunyai peraturan yang terpakai pada seluruh perkataan: setiap huruf memerlukan gaya dan ketinggian yang sama, jarak mestilah sekata, dan huruf mesti berada pada baris yang sama. Satu goresan tambahan, huruf yang tertinggal atau huruf yang berganda jelas kelihatan kepada sesiapa yang membaca bahasa itu, walaupun bahagian lain imej kelihatan nyata.
Model mungkin tidak pernah melihat huruf yang anda taip
Sebelum penjana boleh menggunakan prompt anda, komponen yang dipanggil pengekod teks menukarnya menjadi nombor. Banyak pengekod teks mula-mula memecahkan prompt kepada token. Perkataan biasa selalunya menjadi satu token, manakala perkataan yang lebih jarang dipecahkan kepada beberapa kepingan. Kaedah yang digunakan secara meluas untuk membina kepingan ini ialah pengekodan pasangan bait (byte-pair encoding). Pendekatan ini cekap, tetapi model menerima ID untuk setiap kepingan, bukan huruf di dalamnya. Ia perlu belajar daripada contoh bahawa sesuatu kepingan dilukis sebagai sesuatu barisan huruf.
Satu kertas penyelidikan Google Research, Character-Aware Models Improve Visual Text Rendering, mengkaji perkara ini secara langsung. Para penyelidik membandingkan pengekod teks yang melihat aksara individu (“character-aware”) dengan pengekod yang hanya melihat kepingan perkataan (“character-blind”). Model imej dengan pengekod character-aware memaparkan teks visual dengan lebih tepat, dan ia terutamanya kuat pada perkataan yang jarang. Kertas itu juga mendapati bahawa model bahasa character-blind yang sangat besar boleh belajar mengeja dengan baik. Namun, keupayaan ini tidak berpindah dengan baik di luar bahasa Inggeris dan hanya muncul dalam model yang jauh lebih besar daripada pengekod teks yang biasanya digunakan oleh penjana imej pada masa itu.
Imej latihan selalunya memaparkan teks dengan kurang baik
Penjana belajar daripada koleksi imej yang sangat besar yang dipasangkan dengan penerangan. Dalam imej itu, teks selalunya kecil, kabur, terpotong, dilihat dari sudut serong atau separa tersembunyi, dan ia muncul dalam pelbagai fon dan gaya. Penerangan yang dipasangkan dengan sesuatu imej mungkin langsung tidak menyebut teksnya. Jadi model melihat banyak contoh rupa teks secara umum, tetapi lebih sedikit contoh yang jelas tentang bagaimana sesuatu perkataan tertentu patut dieja dengan tepat.
Teks kecil mempunyai sangat sedikit piksel
Tajuk mungkin merentasi beratus-ratus piksel, manakala satu perkataan tulisan halus mungkin hanya mendapat beberapa piksel bagi setiap huruf. Banyak penjana juga bekerja pada versi imej yang dimampatkan dan membina semula gambar saiz penuh pada akhirnya, yang meninggalkan ruang yang lebih sedikit lagi untuk butiran kecil. Garis halus, seperti palang dalam huruf kecil “e”, mudah hilang.
Mengapa model yang lebih baharu menulis teks dengan lebih baik
Penjana imej telah menjadi jauh lebih baik dalam tajuk dan label yang pendek. Secara amnya, sistem yang lebih baharu menggunakan model bahasa yang lebih kuat untuk memahami prompt, dan pembangun telah memberi lebih perhatian kepada teks semasa latihan. Penyelidikan di atas menunjuk ke arah yang sama: model yang menerima maklumat yang lebih baik tentang huruf melukis teks dengan lebih tepat.
Peningkatan itu nyata tetapi tidak sekata. Penjana yang menulis tajuk tiga perkataan dengan betul masih boleh menghadapi kesukaran dengan satu perenggan, menu atau label dalam bahasa yang kurang kerap dilihatnya semasa latihan.
Di mana penjana imej AI masih menghadapi kesukaran
- Teks yang panjang. Perenggan, menu dan senarai, kerana setiap perkataan tambahan ialah satu lagi peluang untuk kesilapan
- Teks kecil. Tulisan halus, label dan teks yang jauh dalam sesuatu pemandangan
- Perkataan yang luar biasa. Nama, perkataan rekaan, istilah baharu dan nombor panjang seperti nombor telefon atau kod
- Sistem tulisan bukan Latin. Arab, Cina, Hindi, Jepun, Korea, Thai dan sistem tulisan lain, serta huruf beraksen
- Banyak blok teks. Poster dan infografik dengan beberapa keping teks yang berasingan
- Permukaan melengkung atau serong. Teks pada botol, bendera atau papan tanda yang dilihat dari sisi
- Konsistensi. Memastikan perkataan yang sama kekal serupa dalam satu siri imej
Ini ialah corak umum dan bukan peraturan tetap, dan ia berbeza antara satu penjana dengan penjana yang lain serta antara satu versi dengan versi yang lain.
Cara mendapatkan teks yang lebih baik apabila anda menjana imej
- Letakkan perkataan yang tepat dalam tanda petikan. Contohnya, minta poster dengan tajuk “NIGHT MARKET” dan bukannya poster tentang pasar malam.
- Pastikan teks pendek. Beberapa perkataan dalam saiz besar lebih mudah dibuat betul daripada ayat penuh. Letakkan teks yang lebih panjang dalam kapsyen atau pada halaman web sebagai ganti.
- Nyatakan di mana teks diletakkan. Terangkan kedudukan dan saiznya, seperti “tajuk besar di bahagian atas” atau “label kecil pada balang”.
- Minta huruf yang ringkas. Huruf besar yang tebal dan bersih pada kawasan yang ringkas lebih mudah dilukis oleh model berbanding tulisan sambung hiasan di atas latar belakang yang padat.
- Buat beberapa versi. Jana beberapa pilihan, pilih yang mempunyai ejaan terbaik, dan betulkan hanya apa yang tinggal.
- Tambah teks yang tepat kemudian apabila ia penting. Untuk menu, senarai harga atau apa-apa yang mempunyai tulisan halus, jana imej dengan ruang kosong dan susun teks dalam alat reka bentuk. Dengan itu perkataannya ditaip, bukan dilukis.
Cara membetulkan teks selepas itu
Jika gambar itu betul tetapi perkataannya salah, anda mempunyai empat pilihan utama. Inilah pilihan itu daripada yang paling kurang usaha kepada yang paling banyak.
| Kaedah | Usaha | Apa lagi yang boleh berubah | Paling sesuai apabila |
|---|---|---|---|
| Jana semula imej | Rendah | Segala-galanya, kerana anda mendapat gambar baharu | Seluruh imej salah, atau anda tidak kisah kehilangan versi ini |
| Pilih dan sunting dalam penjana | Rendah | Kawasan berhampiran juga boleh dilukis semula | Anda mahukan pembetulan pantas dalam alat yang sama |
| Alat penggantian teks AI | Rendah hingga sederhana | Kawasan teks dilukis semula, jadi semak hasilnya | Gambar itu betul dan hanya perkataannya yang salah |
| Betulkan secara manual dalam penyunting imej | Tinggi | Hanya apa yang anda ubah | Anda memerlukan kawalan penuh, contohnya untuk kerja cetakan atau klien |
Jana semula imej
Menjana semula memerlukan sedikit usaha, tetapi hasilnya rawak. Percubaan baharu mungkin membetulkan perkataan itu dan merosakkan sesuatu yang lain, seperti wajah, tangan atau susun atur. Gunakannya apabila anda belum menghabiskan banyak masa pada imej yang tepat ini.
Pilih dan sunting di dalam penjana
Sesetengah penjana membolehkan anda menandakan sesuatu kawasan dan menerangkan perubahan. Dalam ChatGPT, misalnya, anda boleh menyerlahkan teks dengan alat pemilihan dan menaip apa yang patut ditulisnya. Pusat bantuan OpenAI menyatakan bahawa serlahan tidak sentiasa tepat, jadi butiran berhampiran teks juga boleh berubah. Untuk penjelasan lanjut, lihat ChatGPT boleh edit teks dalam gambar.
Gunakan alat penggantian teks AI
Alat penggantian teks mengesan teks dalam imej untuk anda, jadi anda hanya perlu menaip ejaan yang betul. Dengan EditText.ai, misalnya, anda mengedit tulisan dalam gambar baris demi baris, dan setiap baris dilukis semula dalam rupa huruf dan latar belakang asal. Untuk satu huruf atau perkataan yang salah, lihat cara membetulkan salah ejaan dalam gambar. Untuk tajuk dan huruf paparan pada reka bentuk acara, lihat cara menukar teks pada poster atau risalah.
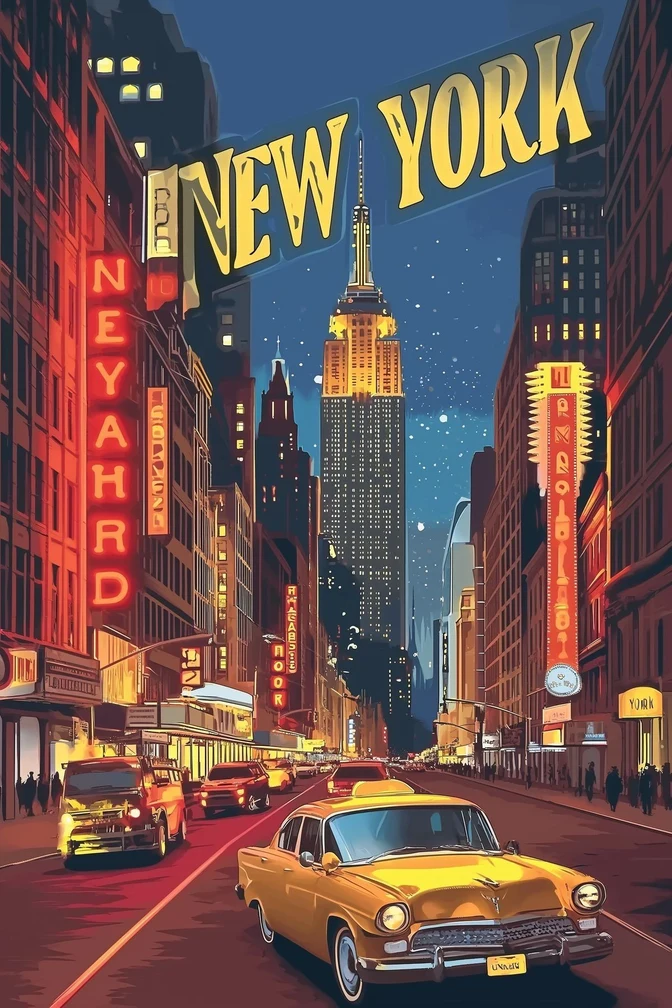
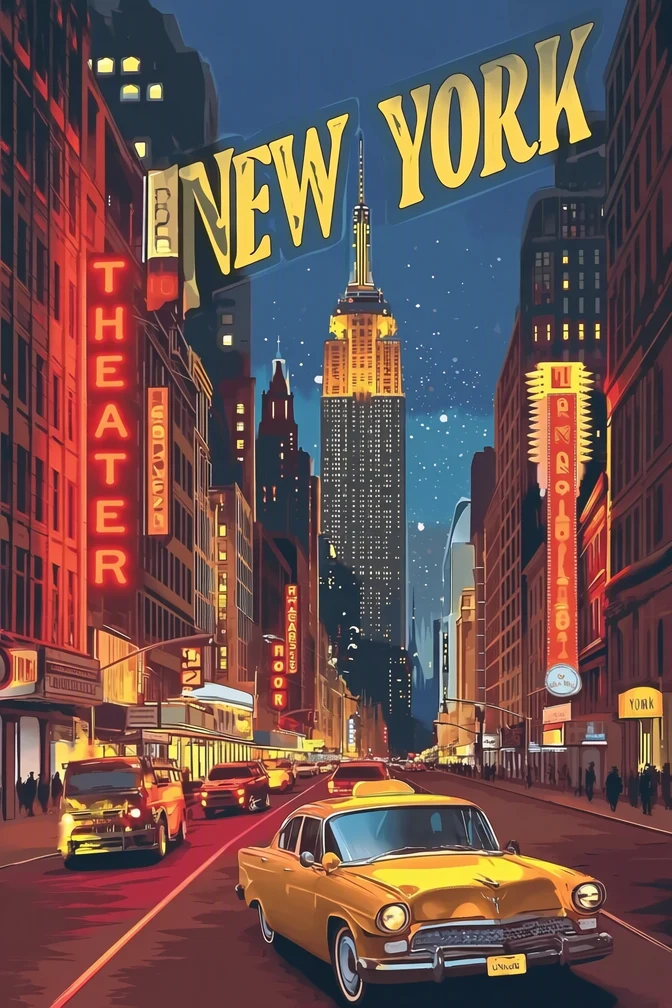
Sebelum dan selepas: papan tanda neon yang bercelaru dalam imej AI, dibetulkan dengan menaip THEATER dalam EditText.ai.
Hasil boleh berbeza-beza, terutamanya dengan huruf yang luar biasa atau latar belakang yang terperinci. Oleh sebab lukisan semula juga dilakukan oleh model imej, baca setiap perkataan baharu huruf demi huruf pada saiz penuh. Mana-mana pengesanan teks juga boleh tersalah baca huruf yang bercelaru, jadi pastikan setiap baris yang dikesan ialah baris yang anda maksudkan untuk diubah.
Betulkan secara manual
Dalam Photoshop, Photopea atau penyunting yang serupa, anda membuang huruf yang rosak, membina semula latar belakang dan menyusun teks baharu dalam sesuatu fon. Ini memberi anda kawalan yang paling banyak dan sesuai untuk kerja cetakan atau klien, tetapi ia memerlukan kemahiran dan masa. Huruf janaan AI selalunya bukan fon sebenar, jadi pencari fon mungkin tidak menemui padanan. Baca cara cari fon daripada gambar untuk cara mencari pengganti yang hampir.
Satu peraturan mudah membantu anda memilih: jika seluruh imej salah, jana semula. Jika hanya perkataannya yang salah, betulkan perkataannya.
Pilihan lain
Anda juga boleh membuang tulisan dalam gambar sepenuhnya dan menyusun teks sebenar pada latar belakang yang bersih dalam alat reka bentuk, pendekatan yang baik untuk menu dan senarai harga. Setelah perkataannya betul, anda boleh menterjemah teks dalam gambar untuk membuat versi dalam bahasa lain.
Sunting hanya imej yang anda miliki atau yang anda mendapat kebenaran untuk mengubahnya, jangan buang tera air atau kredit, dan kekalkan sebarang label imej AI yang diwajibkan oleh sesuatu platform.
Betulkan perkataan dan kekalkan gambar
Jika imej itu betul tetapi ejaannya salah, anda tidak perlu bermula semula. Muat naik imej itu untuk membetulkan teks dalam imej AI dengan EditText.ai, taip perkataan yang betul untuk setiap baris, dan semak hasilnya sebelum anda memuat turunnya.
Soalan lazim
Mengapa AI selalu tersilap menghasilkan teks dalam imej?
Penjana imej AI melukis teks sebagai bentuk dan bukannya menaipnya sebagai huruf, dan banyak yang membaca prompt dalam kepingan perkataan dan bukan aksara tunggal. Teks juga ialah butiran kecil dengan peraturan yang ketat, jadi satu goresan yang salah menonjol. Imej latihan selalunya menunjukkan teks yang kecil, kabur atau serong, yang memberi model lebih sedikit contoh yang jelas untuk dipelajari.
Mengapa AI menulis perkataan yang tidak bermakna dan bukannya perkataan sebenar?
Apabila model tidak pasti bagaimana sesuatu perkataan dieja, ia masih melukis bentuk yang kelihatan seperti huruf, kerana itulah rupa teks dalam imej latihannya. Hasilnya boleh berupa tanda seperti huruf, abjad yang bercampur atau perkataan rekaan. Ia paling kerap berlaku dengan teks yang panjang, huruf kecil dan perkataan yang luar biasa, dan kurang kerap dengan frasa pendek dalam tanda petikan.
Penjana imej AI yang mana paling baik dalam teks?
Tiada jawapan yang kekal, kerana model kerap berubah dan setiap versi baharu boleh bertindak secara berbeza. Secara amnya, penjana terkini mengendalikan teks yang pendek dan besar dengan lebih baik daripada yang terdahulu. Ujian yang paling berguna ialah prompt anda sendiri: jana frasa pendek yang sama dalam alat yang boleh anda akses, kemudian semak ejaan huruf demi huruf sebelum anda memilih satu.
Bolehkah saya membetulkan teks yang salah eja dalam imej AI tanpa menjana semula?
Boleh. Anda boleh memilih kawasan itu dan menerangkan pembetulan dalam penjana yang sama, menaip semula teks secara manual dalam penyunting seperti Photoshop atau Photopea, atau menggunakan alat penggantian teks yang mengesan perkataan supaya anda boleh menaip ejaan yang betul. Apa pun kaedah yang anda gunakan, bandingkan hasilnya dengan yang asal untuk mengesan perubahan berhampiran teks.
Mengapa pencari fon tidak dapat mengenal pasti huruf dalam imej AI saya?
Penjana AI biasanya melukis huruf daripada corak yang dipelajarinya, bukan daripada fail fon yang dipasang. Huruf itu mungkin menggabungkan ciri beberapa muka taip, atau berubah bentuk dari satu huruf ke huruf seterusnya. Pengecam fon mungkin masih mencadangkan fon yang serupa, yang membantu jika anda merancang untuk menaip semula teks itu, tetapi padanan yang tepat selalunya tidak wujud.